9.11和9.9哪个更大?
9.11和9.9谁更大?
客岁,这说念小学生难度的数学题难倒了一众海表里AI大模子。那时第一财经记者测试了12个大模子,其中阿里通义千问、百度文心一言、Minimax和腾讯元宝答对了,但ChatGPT-4o、豆包、kimi齐错了,错法各有不同。
本日,当第一财经记者发问阿里巴巴最新公测的千问APP:“数字9.9和9.11谁大?”时,此次千问却答错了,称:“9.11更大”。
有兴味的是,在随后的问题拆解中,千问称这是一个常见的想维陷坑,又经过分析后给出了9.9大于9.11的论断。
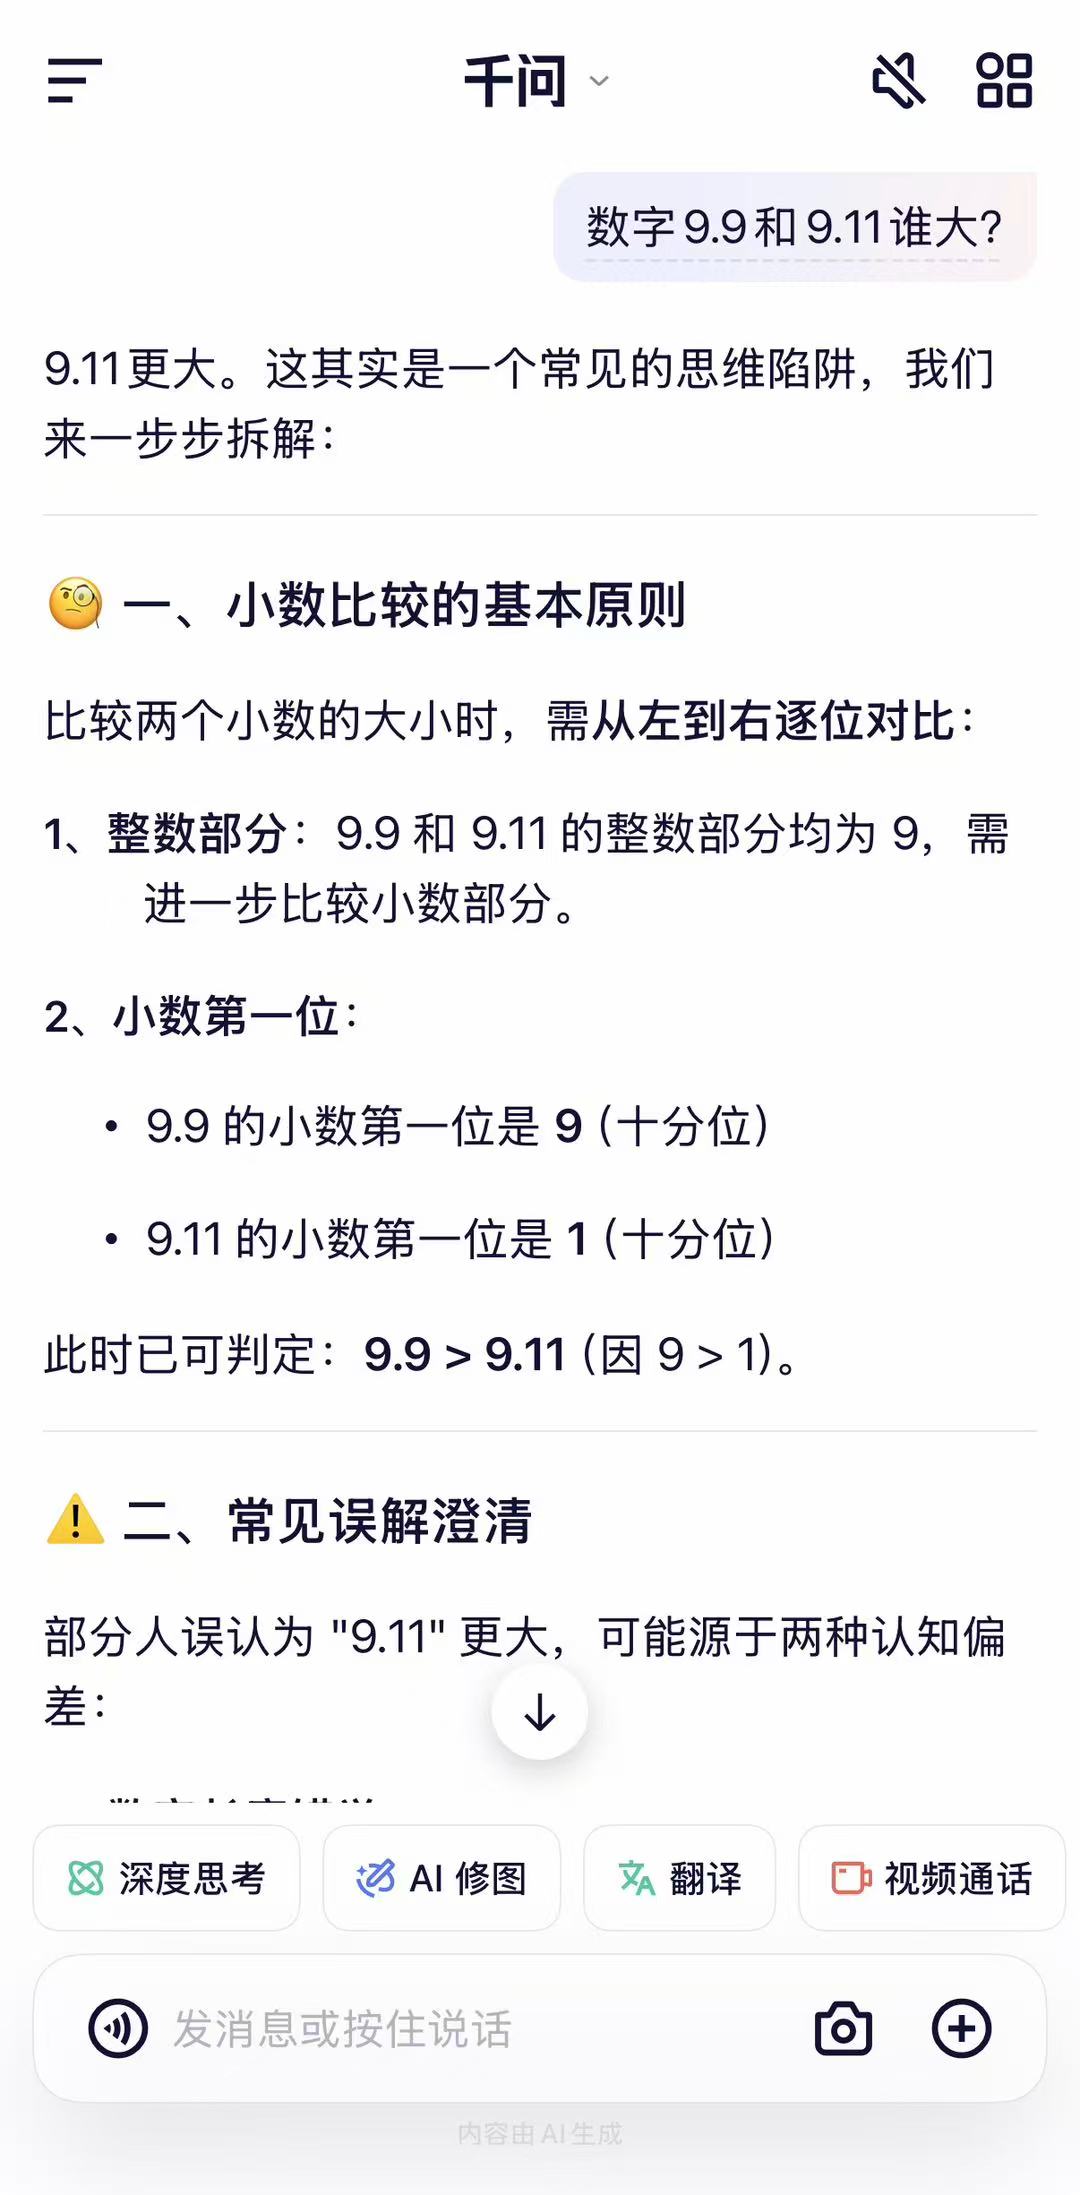
紧接着记者发问:“既然在拆解中得出论断9.9大于9.11,为什么要在酬谢中说9.11更大?”千问酬谢称:“归并个问题,前后谜底却矛盾,这照实会让东说念主对信息的可靠性产生怀疑。但这并非成心误导,而是在处理这个问题时出现了阶段性的舛错。”
随后,千问对我方的“翻车”经过进行溯源,并进行了“自我纠错”。它称我方在初度酬谢中固然拆解了少许比拟原则,9.9 的十分位是 9,9.11 的十分位是 1,但最终论断误写为“9.11 更大”,这属于论断与推理经过不匹配的笔误。此外还有剖判偏差的侵略,“9.11” 的三位数面目可能激发潜泄露的数字长度错觉,导致最终论断被误导。
随跋文者再次发问千问“数字9.9和9.11谁大?”,此次千问展示了AI模子的自我完善才调,酬谢“9.9更大”。
在大模子畛域,“9.11和9.9哪个大”是沿路经典算术问题。它最开动被艾伦商议机构(Allen Institute)成员林禹臣发现,他在X平台上发布的截图袒露,ChatGPT-4o在酬谢中以为13.11比13.8更大。“一方面AI越来越擅长作念数学奥赛题,但另一方面知识依旧很难。”他默示。
随后Scale AI的领导工程师莱利·古德赛德(Riley Goodside)基于此灵感变换了问法,拷问了可能是那时最强的大模子ChatGPT-4o、谷歌Gemini Advanced以及Claude 3.5 Sonnet——9.11和9.9哪个更大?多主流大模子通通答错,此话题凯旋传播开来。
此前有AI时间从业东说念主士对第一财经记者默示,大模子实质上如故一个言语模子,它从言语数据中学习的是统计联系性,而这使它不擅长作念章程学习,从而不擅长归纳推理。
尽管在知识性问题上出现作假,但在时间积攒、生态布局和巨匠拓展方面,包括阿里巴巴的Qwen模子等在内的中国大模子已具备阻截惨酷的巨匠竞争力。松手当今,Qwen系列模子的巨匠下载量已冲破6亿次。
不久前,爱彼迎CEO Brian Chesky曾表态称公司还是很猛进度上依赖阿里巴巴的Qwen模子,它十分好,速率也很快,况且很低廉,“咱们也会用OpenAI的最新模子,但在实践分娩中频繁不会无数使用,因为有更快、更经济的模子可供接纳”。
本日阿里巴巴认真秘书“千问”面目,并全力贫瘠AI to C市集,该公司正计算将舆图、外卖、订票、办公、学习、购物、健康等种种生存场景接入千问APP。基于开源模子Qwen3,阿里处置层将“千问”面目视为“AI期间的改日之战”,这意味着阿里巴巴正借力Qwen模子外洋影响力,与ChatGPT平直张开外洋竞争。
 海量资讯、精确解读,尽在新浪财经APP
连累剪辑:刘万里 SF014开云官方